更好的 context,更好的 verifier。
Prompt-Aware Rubrics(PAR) 是一个面向视频生成的 verifier(reward)框架。在视频生成中,结果是否满足要求往往难以用固定规则验证。PAR 的灵感来自人类评测专家的工作流程:定义标准,将标准转化为针对具体任务的检查项,再培训评估人员,使其以一致的口径应用这些检查项。
PAR 组件。 PAR 将上述流程实现为评价标准手册(Rubric Handbook)、出题模型(Rubric Generator)和经过训练的答题模型(Rubric Verifier)。手册和出题模型为 verifier 构造更好的 context,将开放式评测转化为明确、与任务绑定的问题。这也让 PAR 能够伴随答题模型的能力提升而扩展:基座能力越强,有针对性的 rubric 就越有机会激发这些能力。
PAR 迭代。 PAR 提供三个版本:Single PAR → Agentic PAR V1 → Agentic PAR V4。三者共享相同的 Rubric Handbook 和 Rubric Generator,逐步将 Rubric Verifier 从单一答题模型扩展为融合多种专家工具、结合 workflow harness 的 reward system。
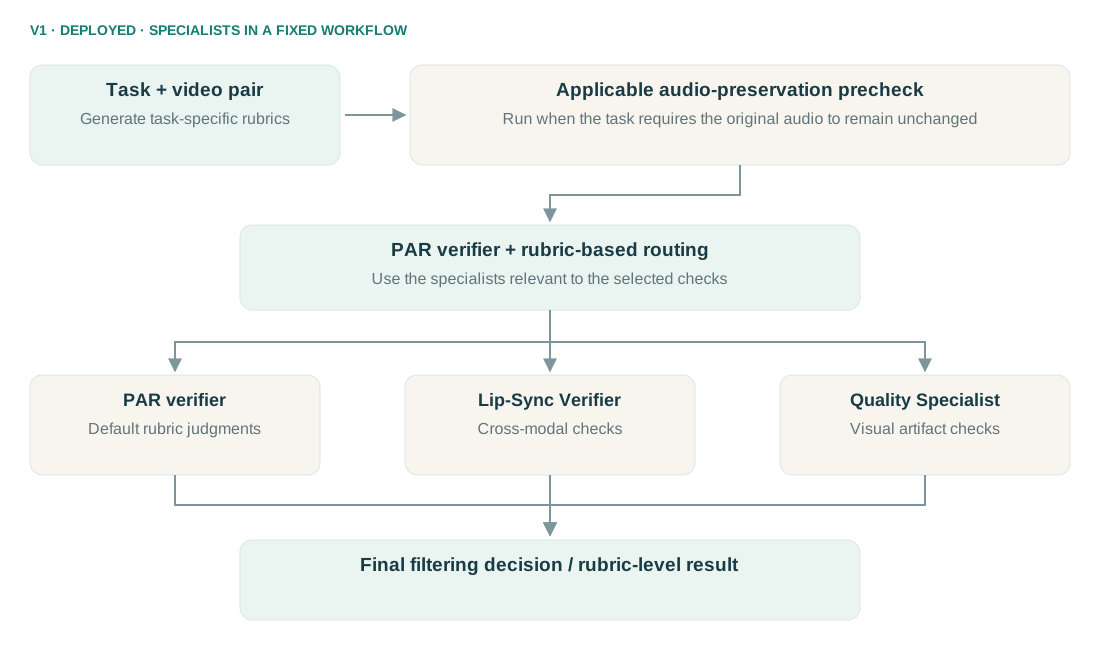
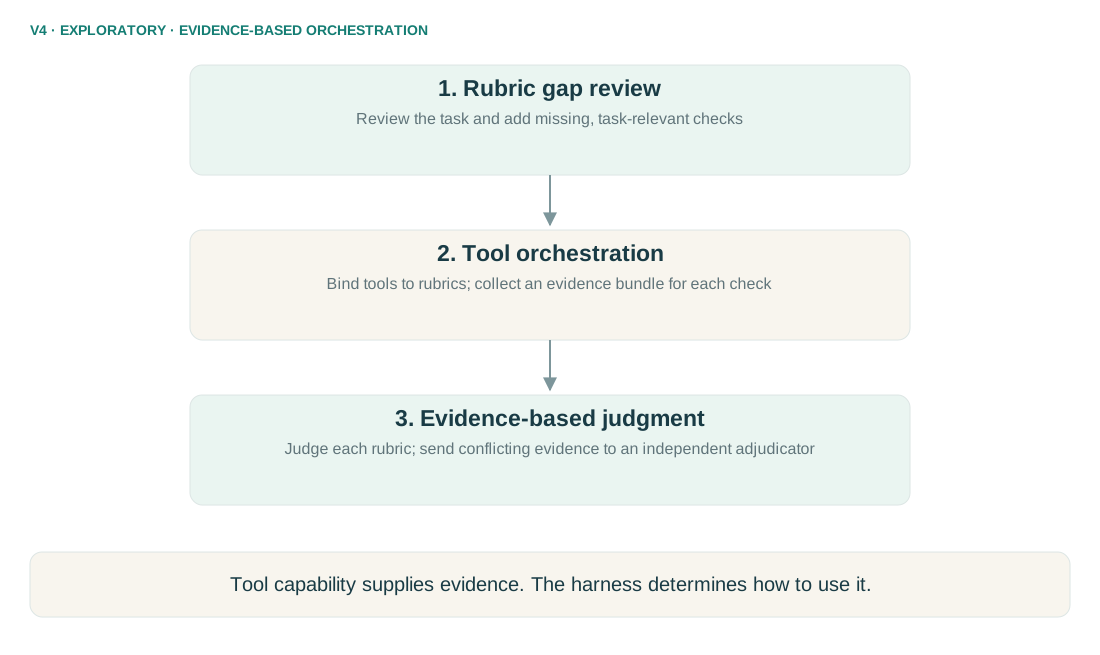
Single PAR 使用一个经过训练的答题模型;Agentic PAR V1 通过固定路由引入专家工具,补强模型能力;Agentic PAR V4 将每条 rubric 与多种工具绑定,通过 workflow harness 组织证据并逐 rubric 做出判断。
三个版本都以任务相关的检查项作为统一接口,逐步扩展答题能力,并让证据处理更加有序。Single PAR 和 V1 已上线,V4 仍处于探索阶段。
PAR 的未来形态。 长期方向是混合式 verifier:用 System 1 快速、直接地决策;对特定 rubric 类别启用 System 2,结合更复杂的思维链推理与工具检查。
对于基座 Rubric Verifier 已经覆盖的能力,可以通过 Rubric Handbook 和 Rubric Generator 构造更好的 context 来激发,并通过训练让判断口径与评测专家对齐,使用 System 1 快速评估。对于直接判断仍不可靠的困难任务,例如识别细小区域的崩坏,则需要更丰富的答题过程:让 System 2 结合 CoT、crop 与 zoom 工具,必要时检查相邻帧,再输出判断。
动机:从人类评测中构造更好的 context
同一个模型,不同的 context
考虑一条包含多项要求的编辑指令:
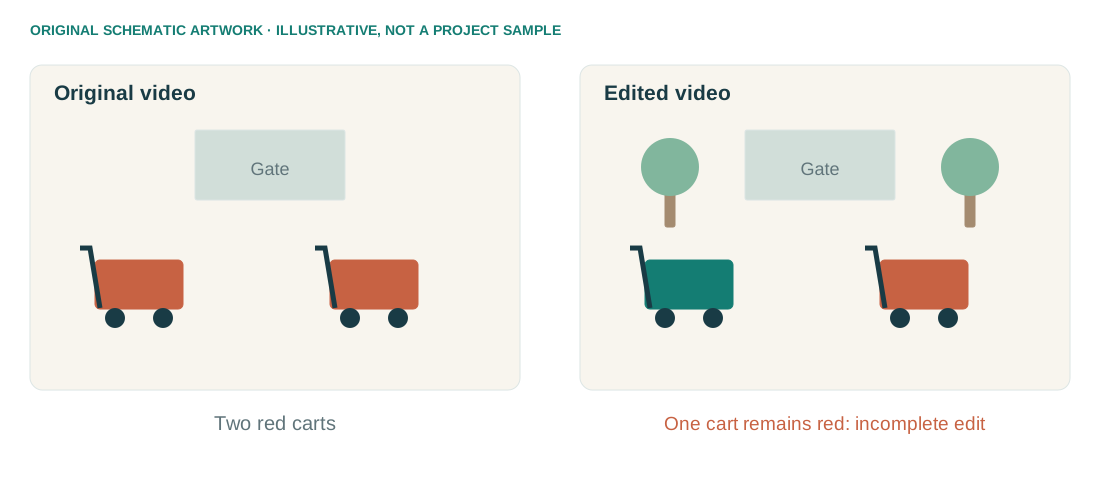
将庭院中所有红色送货推车改成蓝色,在大门附近添加两棵树,并保持原有的镜头运动、节奏和时长。
固定、通用的评测提示可能只会问:“编辑后的视频是否满足用户指令?”模型需要自行拆解要求、决定看哪里、比较相关区域,再将所有发现压缩成一个判断。当注意力集中在整体场景时,它可能漏掉仍然是红色的推车。
换成一个具体问题:“庭院中所有红色送货推车是否都已变成蓝色?”视频没有改变,verifier 也没有改变,但 context 明确指定了对象、属性与目标变化。模型在通用问题下漏判,并不必然意味着它无法识别颜色;也可能是相关能力没有被有效激发。
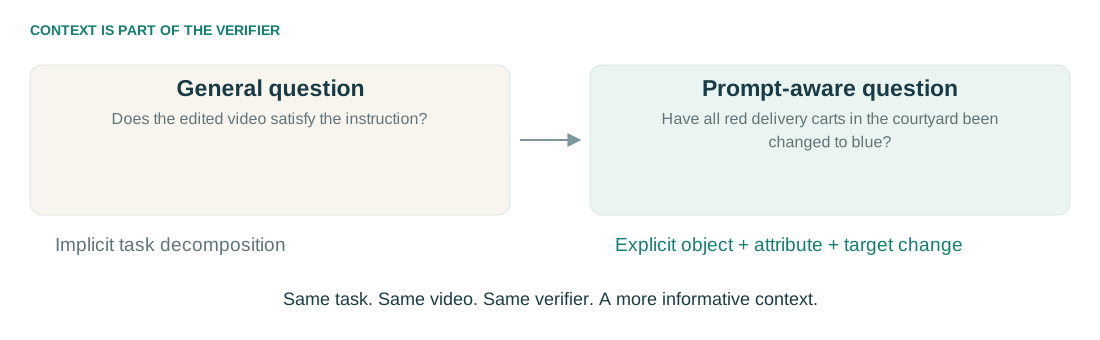
由此得到一个实际的研究问题:如何系统地构造 context,让 verifier 更好地使用它已经具备的能力?
借鉴人类评测专家的工作流程
人类评测在打分前就已开始:专家先确定哪些方面重要,区分失败类型,并形成标准文档,再培训评估人员以一致的方式应用标准。直接要求模型“判断这个视频”,往往跳过了其中大量工作。
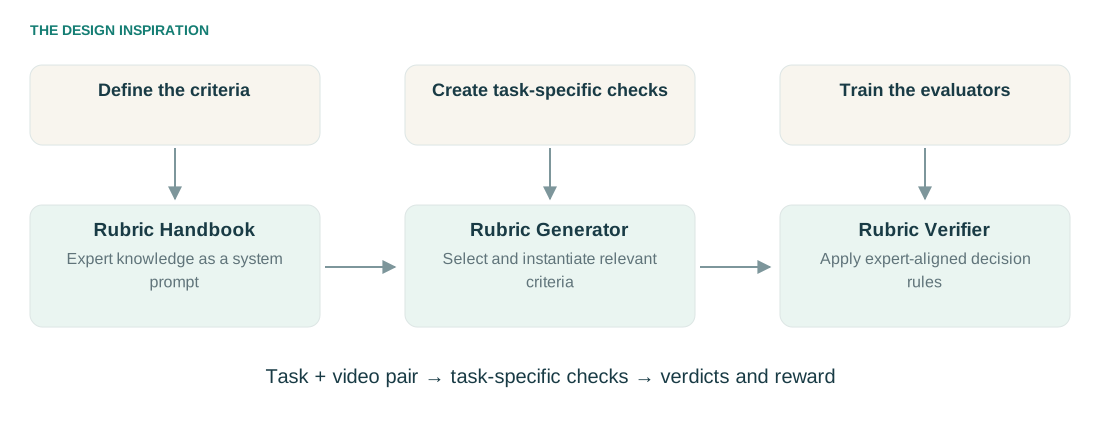
PAR 有三个组件:Rubric Handbook 以出题模型 system prompt 的形式存储专家经验;Rubric Generator 将用户指令转化为具体检查项;Rubric Verifier 根据视频证据,按照与专家对齐的判断标准回答这些问题。
一条 prompt-aware rubric 是什么样的
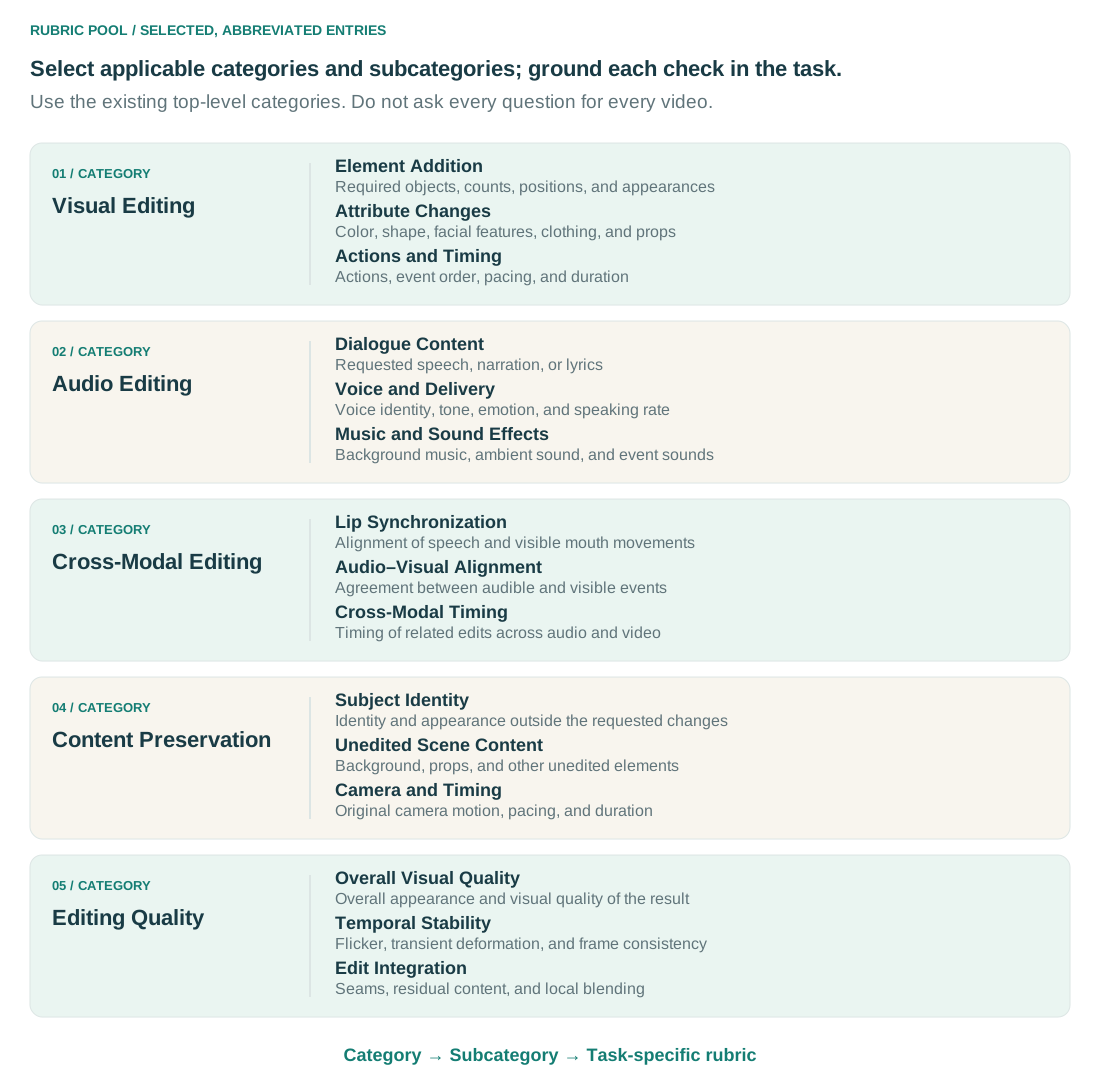
Rubric pool 采用大类(category)与子类(subcategory)两级结构。生成的问题会将选中的准则绑定到具体任务。以下虚拟示例展示这种结构,不复现完整内部 rubric 清单;图中文字和 rubric 示例保留英文。
Change every red delivery cart in the courtyard to blue, add two trees near the gate, and preserve the camera motion, pacing, and duration.
| Category | Subcategory | Task-specific rubric |
|---|---|---|
| Visual Editing | Attribute Changes | Have all red delivery carts in the courtyard been changed to blue? |
| Visual Editing | Element Addition | Have two trees been added near the gate? |
| Content Preservation | Background and Props | Are the original gate and other unedited courtyard elements preserved? |
| Content Preservation | Camera and Motion Continuity | Is the original camera motion preserved? |
| Editing Quality | Edit Integration | Is the cart recoloring temporally stable, without residual red areas or deformation? |
| Editing Quality | Edit Integration | Do the added trees blend into the courtyard without visible seams? |
五个顶层类别——Visual Editing、Audio Editing、Cross-Modal Editing、Content Preservation 和 Editing Quality——来自真实业务中视频编辑任务与专家评测的实践经验,覆盖反复出现的编辑要求和失败类型。纯视觉编辑任务只需选择相关检查项,无需从每个类别中都出题。
推理时的流程是:手册 + 编辑指令 → rubrics → 视频验证 → 逐 rubric 判断与聚合分数。每个检查项回答“1”的概率可以作为聚合所用的软分数。同一种表示能够支持可解释评测、数据筛选,以及后训练的奖励构造。
PAR:单一验证模型
Handbook 本质上是出题模型的 system prompt
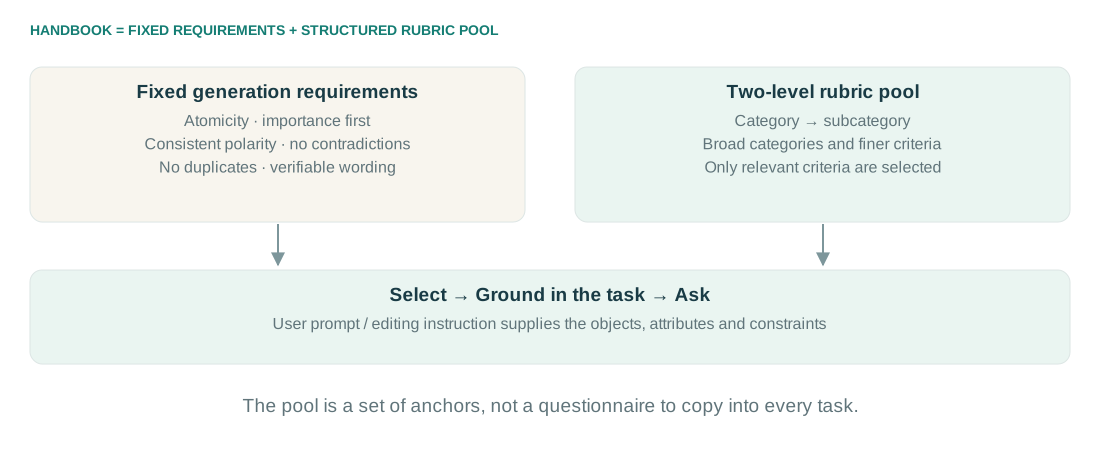
Handbook 以文本形式写入出题模型的 system prompt,由两部分组成:固定的出题要求,以及结构化的 rubric pool。
固定要求包括:追求原子化、在题目预算内优先覆盖重要要求、统一判断极性、避免矛盾和重复。回答“是”始终代表该要求被满足;回答“否”则代表未满足、完成不充分,或缺少足够证据支持。
Rubric pool 提供可选择的两级类别与准则,包含较大的评测维度及更细的标准,并在迭代中扩展覆盖率。给定用户 prompt 或编辑指令,出题模型从 pool 中选择适用条目,再结合具体对象、属性、动作和保留约束构造问题。
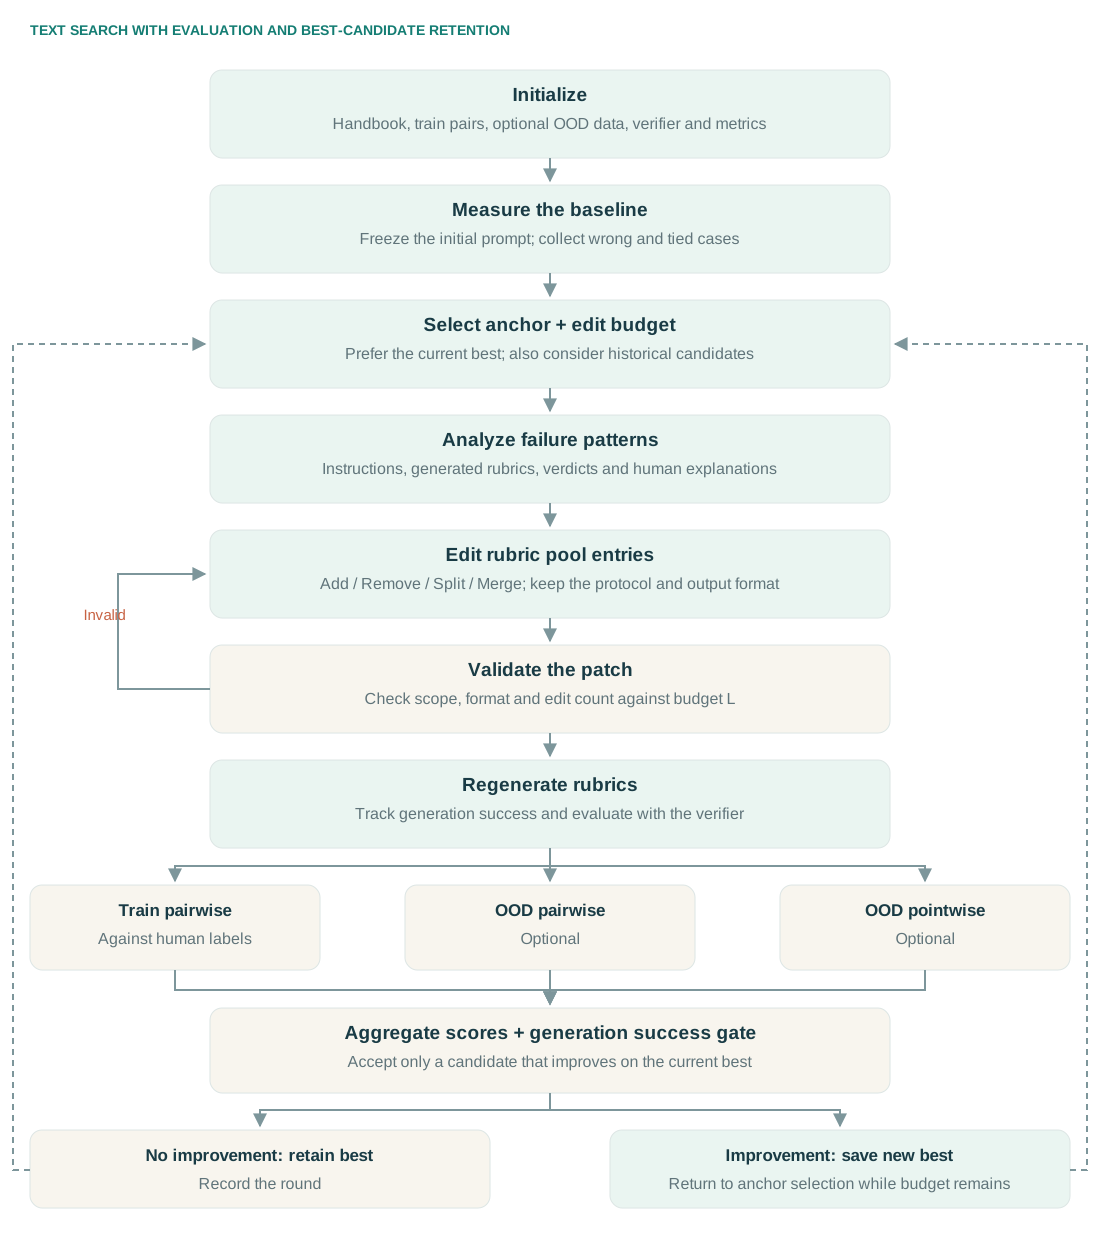
手册构建分为三步。首先,从专家经验形成初始规则与 pool;其次,从推理错误和 RL 反馈中发现尚未覆盖的任务要求与失败类型。这一步的目的是增加 rubric pool 对真实数据和训练场景的覆盖率。最后,通过自动化搜索提出新增、删除、拆分和合并操作。
搜索循环先评估初始手册,再从当前或历史版本中选择优化起点并分配编辑预算。随后分析判断错误或打平的样本,提出 pool 修改,检查补丁的范围与格式,重新生成 rubrics,并用 verifier 评估候选版本。只有同时通过生成成功率门槛、并取得效果提升的版本,才会替代当前最优版本。
手册迭代同时改变了出题模型“能问什么”和“能问多细”。相较之前的版本,三处变化尤其具体:
Rubric Handbook 的三处变化
- 每条 case 的 rubric 数量上限从 12 → 14。增加题目预算,为重要要求留出独立、原子化的检查空间。
- 进一步细分属性、动作、文字和音频等准则。例如五官、服装、道具、动作顺序与节奏、文字布局及独立音频要求,减少将不同错误混在一道题中的情况。
- 新增 rubric:[Editing Quality][Overall Visual Quality]。除检查指定编辑和局部缺陷外,显式检查编辑结果的整体画面质感。
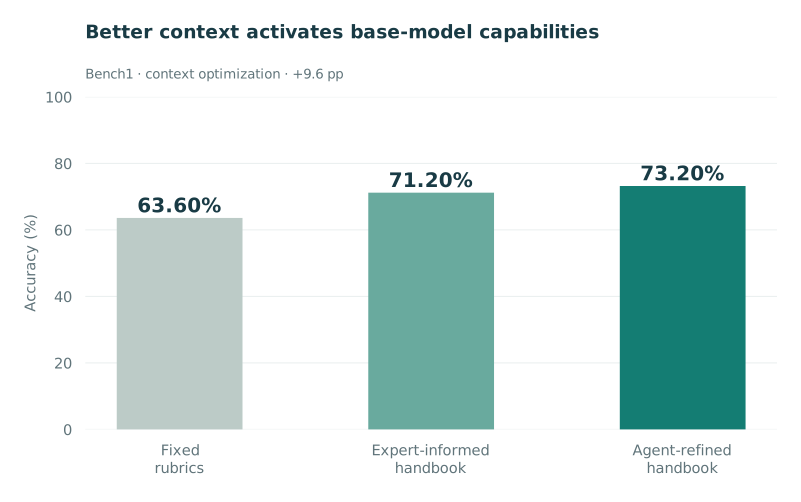
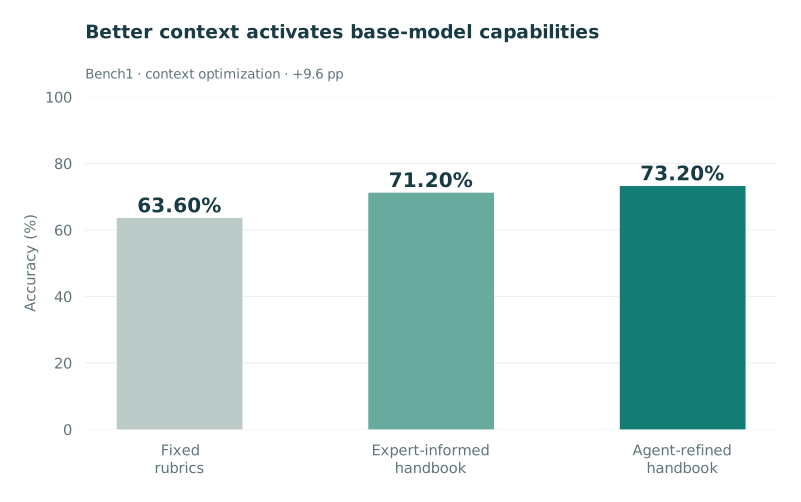
手册迭代在 Bench1 上的结果如下:
好的手册降低对出题模型强弱的敏感性
训练更好的答题模型前,需要先检查生成的问题是否有用。对 1,000 个样本、9,728 条 rubric 的人工审核发现,约 94% 的 rubric 与任务完全相关。不同类别存在差异,其中音频编辑仍是相对薄弱的部分。
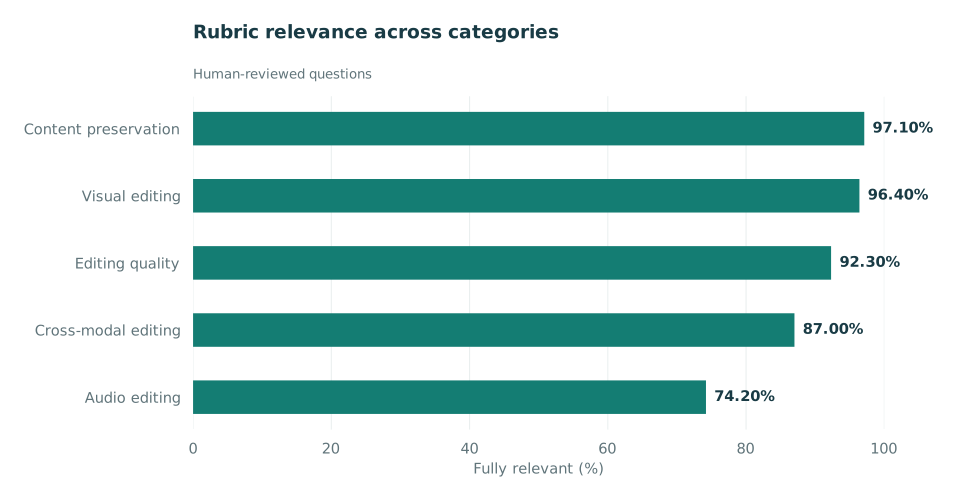
接着,在使用相同详细手册的条件下,对比强外部出题模型与轻量内部出题模型。在这项实验中,两者带来的下游 Bench1 准确率相同。
| 出题模型 | Bench1 准确率 |
|---|---|
| 强外部模型 | 77.1% |
| 轻量内部模型 | 77.1% |
约 80% 的样本,其 rubric 重合率超过 60%;同类别问题中约 85% 的语义一致。94% 相关性来自前述人工审核集合,并非对两个出题模型各自单独测得的结果。
| 表述 A | 表述 B |
|---|---|
| Have all red delivery carts in the courtyard been changed to blue? | Are all delivery carts that were red in the original courtyard now blue? |
这是一组用于说明语义等价的虚拟表述,并非出题模型对比实验的逐字输出。
足够明确的手册,可以降低 PAR 效果对出题模型强弱的敏感性。上述对比中,强外部模型与轻量内部模型生成了语义接近的问题,并达到相同的下游准确率。因此,优化出题手册也体现为优化出题模型的输出:将任务知识与覆盖要求写入指令,再由模型针对每个编辑任务实例化。
直接 GRPO、专家标签与捷径学习
对于一个视频对和 N 条 rubric,答题模型输出长度为 N 的 01 字符串,每一位回答一个检查项。之所以跳过 SFT,是因为训练数据有限,而且基座已经掌握输出格式:给定 N 道题,输出 N 个二分类答案。因此可以直接用 GRPO 优化判断质量。
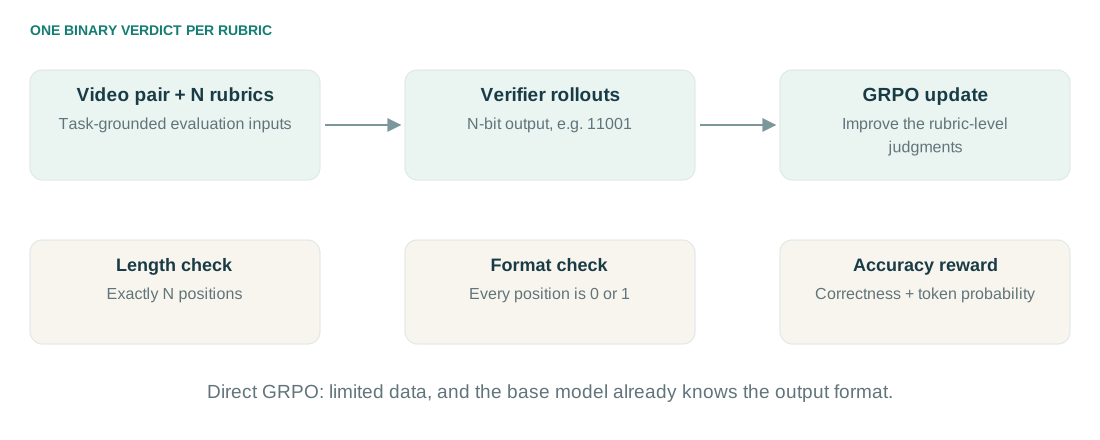
Reward 检查输出长度、二进制格式和逐 rubric 正确性。长度错误会使整个序列无效,非法字符会受到惩罚。对于 rollout i 和 rubric j,与准确性相关的奖励项为:
其中,判断正确时 h 为正,错误时为负;p 是输出 token 的概率。该 verifier 设置中,格式与准确性部分的权重重点为 1:9,各条 rubric 等权。
数据设计与 loss 同样重要。初始训练集约有 11k 个样本,以通过与未通过混合的序列为主。全对样本仅约 5%,全错样本约 0.4%。模型可能学到捷径:题目越多,就越可能有一道不通过。
第一版增强从部分样本中删除未通过的检查项,保留一部分通过项,并打乱顺序。后续版本进一步平衡全对、混合和全错样本,减少 rubric 数量与标签之间的相关性。
| 训练版本 | 约计样本数 | 数据变化 | Bench1 准确率 |
|---|---|---|---|
| 训练基线 | 11k | 初始分布 | 77.1% |
| 数据增强 V1 | 15k | 增加全对样本 | 80.7% |
| 数据增强 V2 | 22k | 全对 / 混合 / 全错 ≈ 30 / 50 / 20 | 81.4% |
| V2 + Gold-Rescue | 未新增源样本 | 针对所有 rollout 都答错的 rubric | 82.7% |
这些是不同实验配置,并非只隔离数据因素的消融;V1 还关闭了 thinking。77.1% 是未做数据增强的训练基线,不是未训练模型的结果。
Gold-Rescue:为整组答错的 rubric 提供学习信号
普通 GRPO 对每个 prompt 采样八个 rollout(K = 8),逐 rubric 计算组内相对优势。困难 rubric 可能在 K 个 rollout 中全部答错。Gold-Rescue 的触发单位是这条 rubric:当所有采样答案都错误时,向组中注入一个 gold answer,提供正向目标。
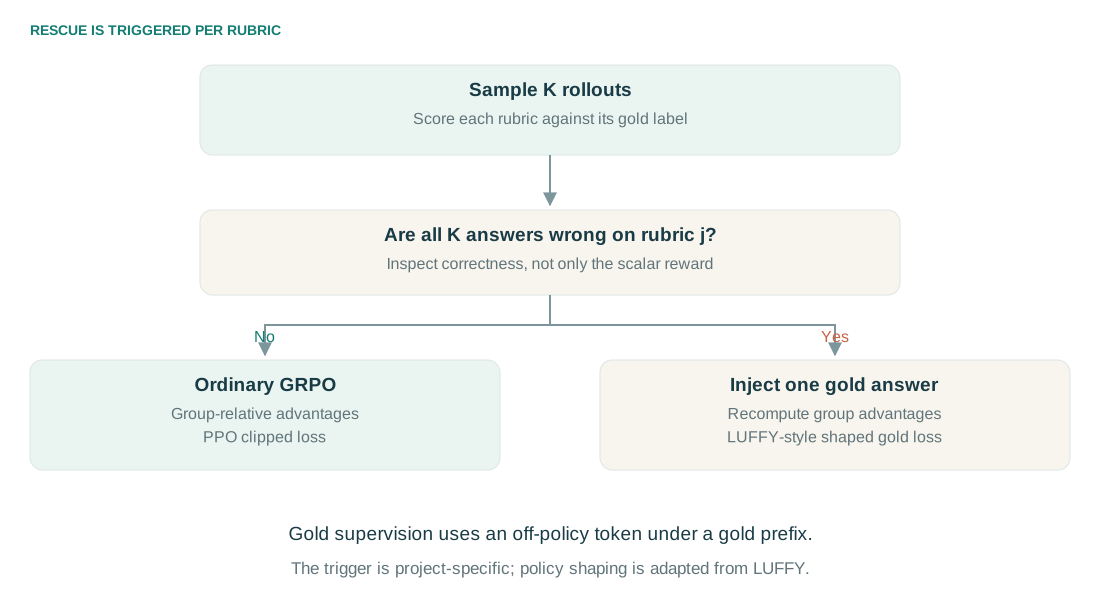
以二元正确性为例,在 K 个错误答案中加入一个正确答案,使用总体标准差归一化后,错误答案的优势为 \(-1/\sqrt{K}\),gold answer 的优势为 \(\sqrt{K}\)。这说明 rescue 如何为原本组内完全一致的结果恢复学习信号。
普通 rollout token 仍采用 PPO clipped loss。记概率比为 \(\rho_t=\pi_\theta(y_t\mid x,y_{<t})/\pi_{\mathrm{old}}(y_t\mid x,y_{<t})\),则逐 token loss 为:
Gold token 在 gold prefix 下计算概率。借鉴 LUFFY: Learning to Reason under Off-Policy Guidance 中的 policy-shaping 函数,使用 \(f(p)=p/(p+\gamma)\)。将 gold teacher 概率视为 1,对应 loss 项为:
当 gold advantage 为正时,最小化该 loss 会提高正确 token 的概率。这个具有饱和特性的变换会重塑离策略更新,并非通常的负对数似然目标。Gold-Rescue 将这一机制用于特定的逐 rubric 触发场景,没有复现完整 LUFFY 训练流程。
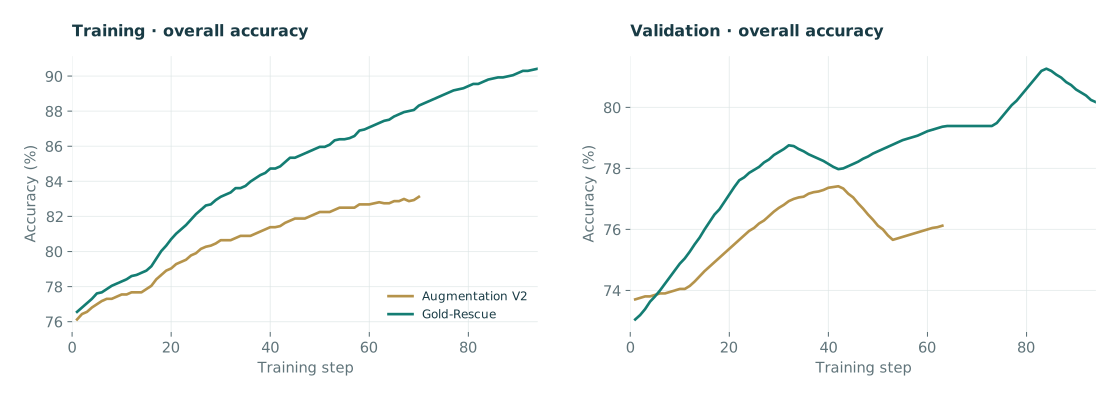
在 Bench1 上,Gold-Rescue 将 V2 verifier 从 81.4% 提升至 82.7%,增加 1.3 个百分点,且无需额外收集源训练样本。
泛化、诊断与 PAR for RL
在保留的编辑评测集 Bench3 上,最大提升来自指令遵循,质量方面的变化较小,为后续失败分析提供了线索。
| 方法 | 整体 | 指令遵循 | 一致性 | 质量 |
|---|---|---|---|---|
| 固定提示基线 | 0.474 | 0.630 | 0.747 | 0.727 |
| Single PAR | 0.747 | 0.857 | 0.805 | 0.734 |
| 外部 SOTA 模型 | 0.630 | 0.662 | 0.792 | 0.792 |
Bench3 使用 0–1 范围的原始评测分数,与 Bench1 准确率不同。在关注音频的 Bench4 上,准确率由固定提示基线的 67.2% 提升至训练后 PAR 的 73.2%。
PAR for RL。一个好的 verifier 也可以作为视频生成后训练的 reward model,以统一标准串联数据合成、RL 训练和评测。PAR 使用同一套任务相关检查项筛选合成数据、构造训练奖励,并评估生成结果。
本地实验表明,相比传统 reward model,PAR 具有更高的判断准确率,而这种提升可以传递为下游更好的生成响应与编辑指令遵循。目前,这一结论局限于策略梯度贡献按 reward 或 advantage 成正比缩放的 RL 方法,尚不能推广到所有 RL 算法。
不同类别的 rubric 权重还提供了额外控制:提高指令遵循、内容保持或质量的权重,可以调整奖励重点,进而引导生成模型的优化方向。
下面的虚拟对话案例展示原子化检查如何让错误更易解释。它专为本文构造,不对应原项目样本或实测模型输出。
Change the first speaker’s line from “Meet me at noon” to “Meet me at dusk,” and the second speaker’s reply from “I’ll bring lunch” to “I’ll bring a lantern.” Keep the lip movements synchronized and preserve the unedited dialogue.
新台词正确,但两位说话者的口型仍然没有与新语音同步。
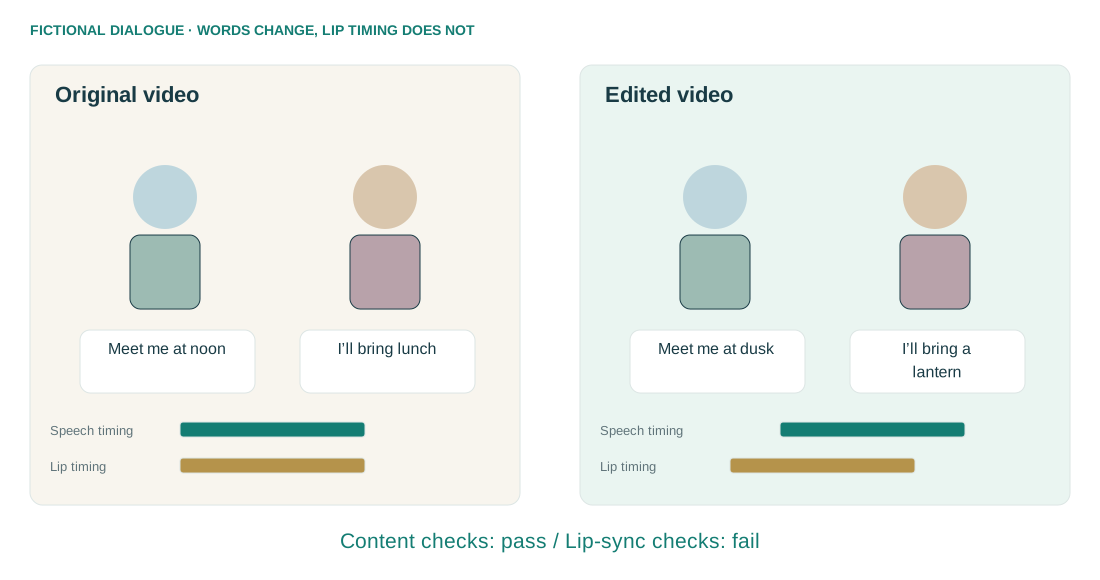
11001用于说明的判断,并非实测输出| Category | Subcategory | Example rubric | 示意答案 |
|---|---|---|---|
| Audio Editing | Dialogue Content | Does the first speaker now say “Meet me at dusk”? | 1 · 通过 |
| Audio Editing | Dialogue Content | Does the reply now say “I’ll bring a lantern”? | 1 · 通过 |
| Cross-Modal Editing | Lip Synchronization | Are the first speaker’s lip movements synchronized with the new speech? | 0 · 未通过 |
| Cross-Modal Editing | Lip Synchronization | Are the second speaker’s lip movements synchronized with the new reply? | 0 · 未通过 |
| Content Preservation | Audio Preservation | Is dialogue outside the edited exchange preserved? | 1 · 通过 |
Agentic PAR:多工具融合与 Harness 设计
上线数据暴露了新的失败类型
更明确的问题可以激发已有能力,但不能保证能力本身足够强。上线后,新数据暴露出答题模型在音频保持与编辑质量方面的弱点。
一种典型模式是:用户只要求替换画面中的物体,视频却连原有音轨也发生了变化。聚焦于视觉指令的 verifier 可能接受这一结果,忽略音频保持失败。对应的定点补强方式,就是为需要保持原音频的任务加入音频一致性专家算子。
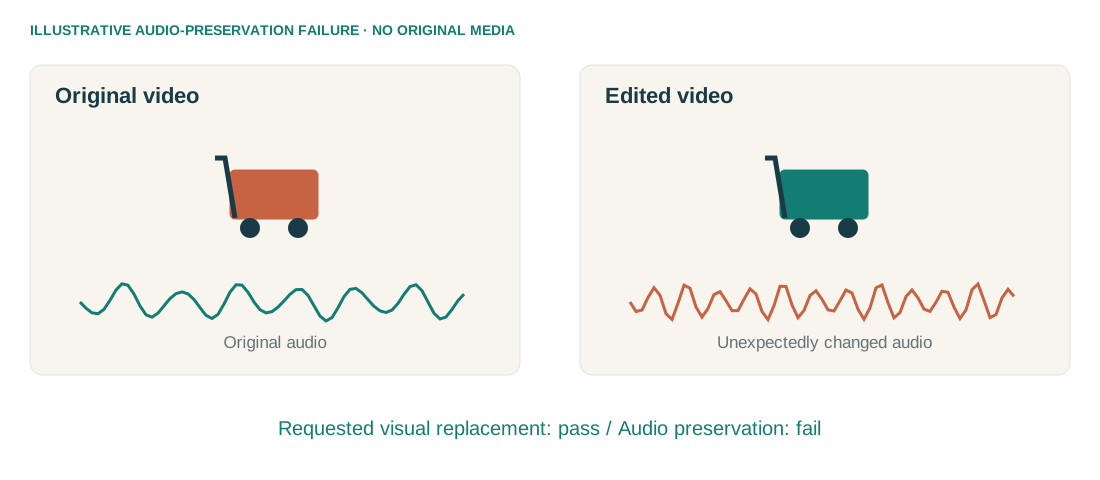
从业务错误定位需要补强的专家能力
在真实业务中,专家评测解释告诉我们编辑为什么失败,任务相关的 rubric 则指出答题模型漏判了哪项要求。两者结合,可以准确定位当前模型的能力缺口,例如仅要求视觉编辑时,无法识别背景音被改变。
一种快速上线的思路是引入专家算子补强薄弱能力:运行当前 verifier,分析业务解释与错误 case,定位相关 rubric,引入专家工具并调整路由,再评估更新后的系统。这样就从单一答题模型扩展为答题模型与多工具池的组合。
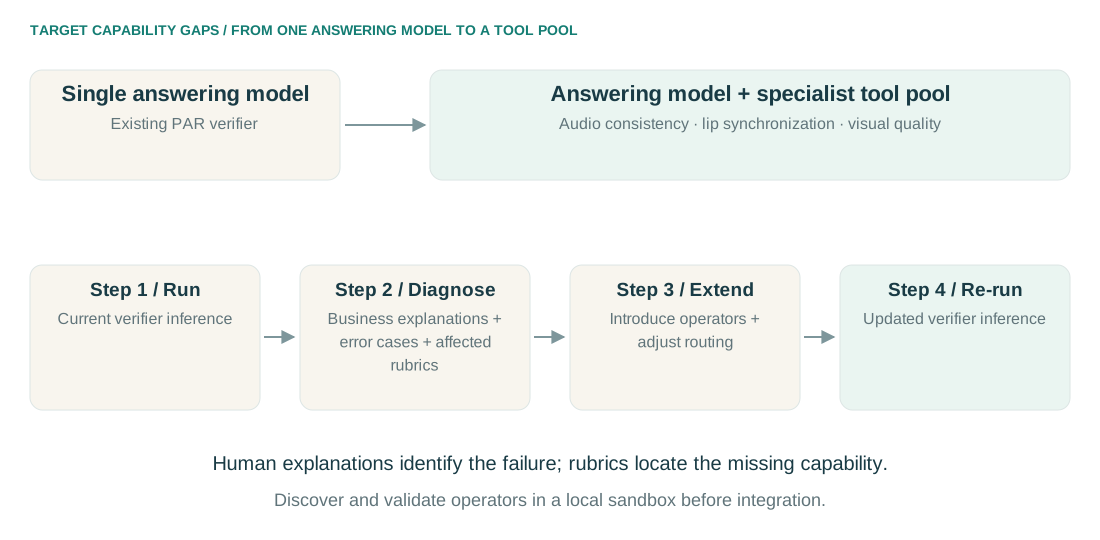
展开 Step 3:算子发现与验证。通过本地沙箱实验寻找适用工具。针对性的验证集包含 50 个异常 case 和 50 个正常 case,由强模型提出并执行候选算子,同时评估错误识别率与误杀率。只有既能识别目标错误、又能保留正常样本的算子,才被选入固定路由流程。
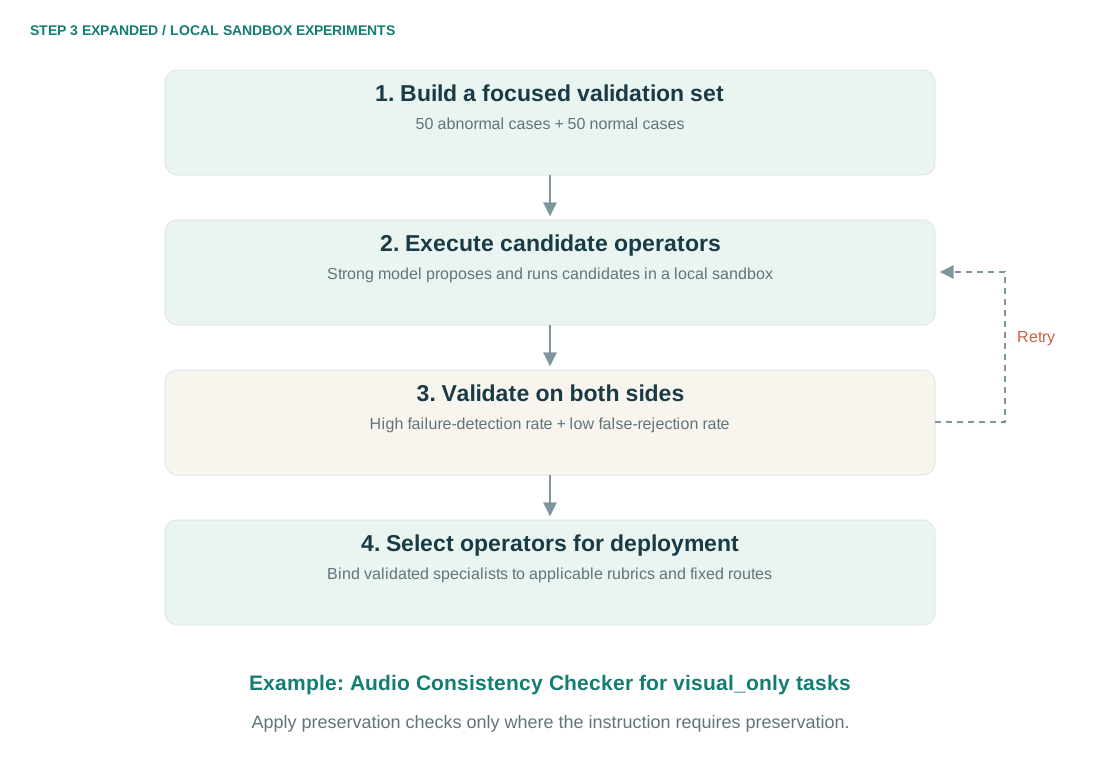
以 visual_only 任务的音频一致性为例,沙箱实验找到了互补的信号级检查,配置阈值如下:
| 信号级检查 | 阈值 |
|---|---|
| 波形相关(Waveform correlation) | ≥ 0.15 |
| 频谱余弦(Spectral cosine similarity) | ≥ 0.65 |
| 平均相干(Mean coherence) | ≥ 0.15 |
| 残差信噪比(Residual SNR) | ≥ 0 dB |
这些数值是该音频保持场景下的配置,仅在编辑要求保持原音频时适用。如果任务明确要求修改台词或音乐,就应使用匹配该要求的检查。同样的发现流程可以引入用于同步问题的 Lip-Sync Verifier,以及用于视觉缺陷的 Visual Quality Specialist。
Agentic PAR V1:固定工作流中的专家工具
Agentic PAR V1 将上述能力放入固定工作流:先执行适用的内容保持预检查,再运行 PAR,并将相关 rubric 类型路由到专家工具。任务条件十分关键:不能因为用户明确要求改变音频,就让音频保持检查直接拒绝样本。
Agentic PAR V4:基于证据的 Harness
V4 探索如何更有效地使用更大的工具池,harness 分为三个阶段:Rubric 回扫(gap review)检查遗漏并补充任务相关的 synthetic rubrics;多工具编排将检查项绑定到工具,为每条 rubric 收集 evidence bundle;基于证据的判断逐 rubric 决策,证据冲突时由独立裁决器处理。
PAR 架构的两个优势
1. 定位并补强具体弱点。业务评测解释与任务相关 rubric 结合,可以定位当前答题模型处理不好的要求,再用专家工具定向补全,使系统更容易随着新错误类型出现而扩展。
2. 通过显式 rubric-to-tool 绑定构建编排。每条 rubric 可以提前绑定多个相关工具,绑定关系及相应规则定义证据如何被收集和处理。我们没有先收集昂贵的 tool-calling 训练数据,再训练通用自主工具调用策略。系统的灵活性来自可扩展工具、任务相关检查与证据处理,扩展系统不需要先经过上述工具调用训练阶段。
与外部 SOTA 集成比较
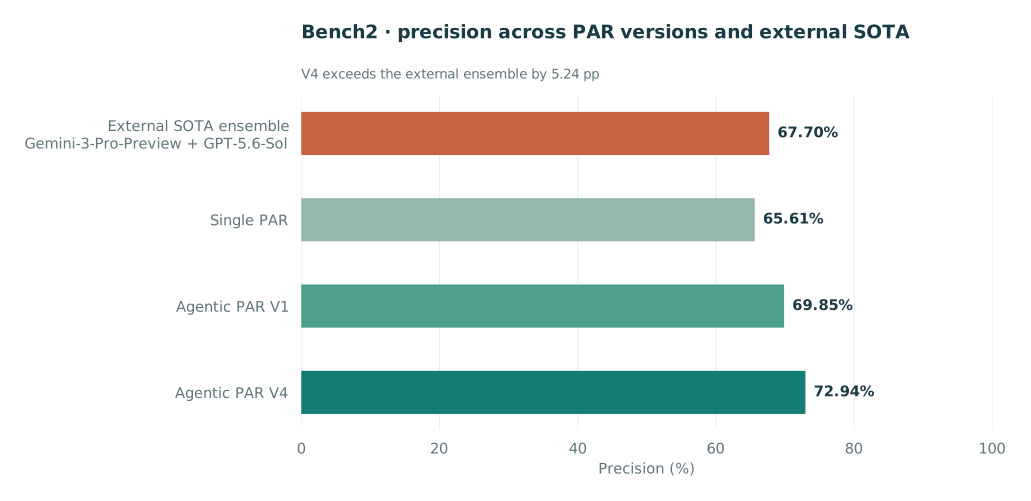
Bench2 是来自真实编辑分布的筛选评测。这里正类代表可用样本:precision 衡量接受样本中的可用比例,recall 衡量所有可用样本中被保留下来的比例。这与第 5 节以崩坏为正类的诊断实验不同。
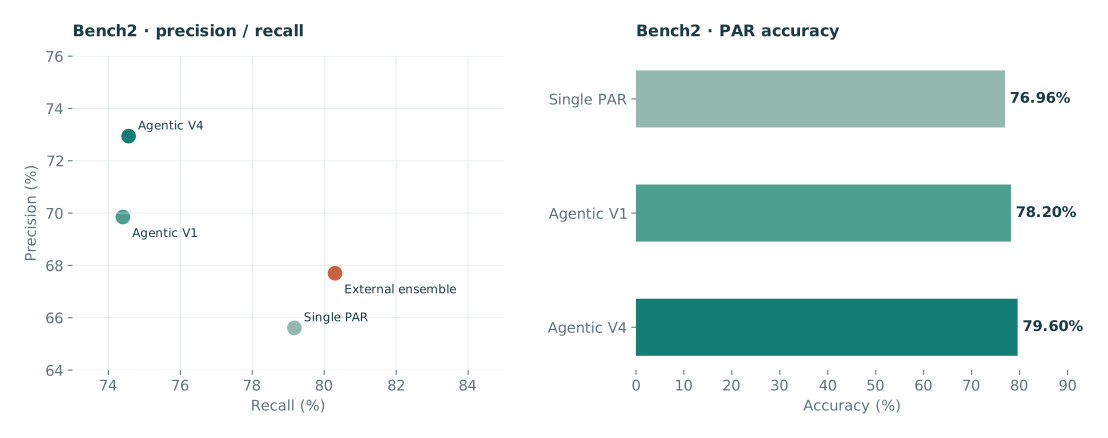
| 方法 | Precision | Recall | Accuracy | F1 |
|---|---|---|---|---|
| Single PAR | 65.61% | 79.17% | 76.96% | 71.76% |
| Agentic PAR V1 | 69.85% | 74.40% | 78.20% | 72.06% |
| Agentic PAR V4 | 72.94% | 74.56% | 79.60% | 73.74% |
| 外部 SOTA 集成 Gemini-3-Pro-Preview + GPT-5.6-Sol | 67.70% | 80.30% | — | — |
Agentic PAR V4 的 precision 超过 Gemini-3-Pro-Preview + GPT-5.6-Sol 外部 SOTA 集成:72.94% 对比 67.70%,提升 5.24 个百分点。从 Single PAR 到 V4,accuracy 从 76.96% 提升至 79.60%,增加 2.64 个百分点。外部集成保留了更高的 recall,因此 precision 提升也反映了筛选中的取舍。
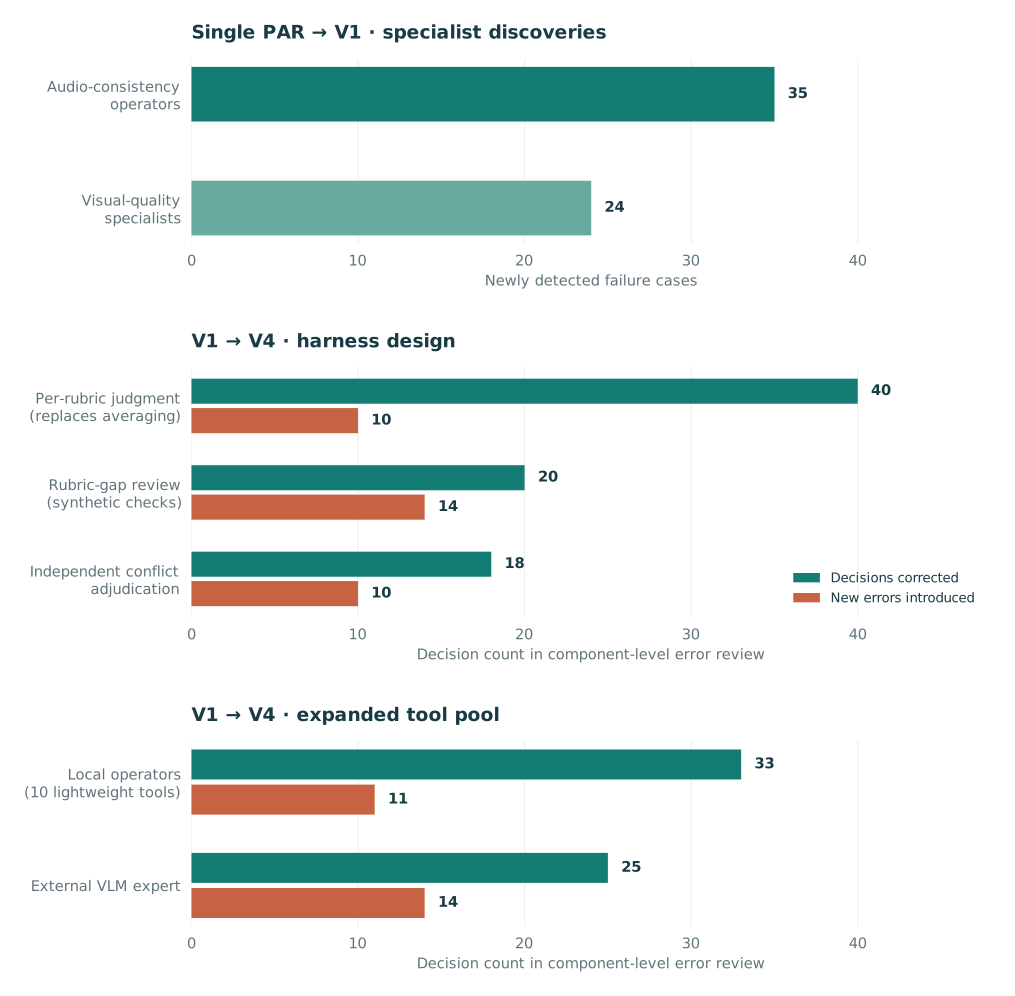
错误复盘进一步解释了版本提升来源。Single PAR → V1 中,音频一致性算子识别出 35 个音频不一致 case,质量专家识别出 24 个低质量 case。V1 → V4 中,workflow harness 与扩展工具池都有贡献:逐 rubric 判断、补漏、冲突裁决、本地算子和外部 VLM 专家各自修正了一些判断,同时也引入了新错误。
真实业务效果:可用与可容忍数据达到 2.20 倍
在真实数据合成管线中,已上线的 Agentic PAR V1 将严格可用 + 可容忍数据占比从 31.0% 提升至 68.06%,其中 60.92% 严格可用、7.14% 可容忍。图中可容忍部分堆叠在严格可用部分之上。
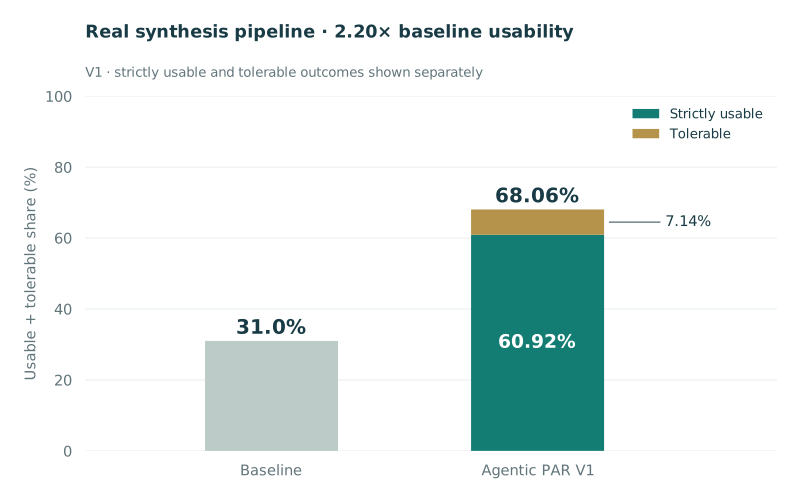
总占比包含可容忍数据,这项业务结果本身不直接量化端到端成本节省。
为什么 PAR 是更好的选择
更好的 context 激发基座原子能力
第一类提升来自明确的任务 context。Rubric 指定要检查什么:目标物体、颜色变化、需保持的背景或同步要求。出题模型提供结合专家经验的 hints,使 verifier 无需自己发现所有相关测试。
手册实验中的 63.6% → 71.2% → 73.2% 与这一机制一致,说明评测问题的构造方式仍有优化空间,但不代表所有剩余错误都能通过提示词解决。
训练答题模型,与评测专家对齐
第二类提升来自判断标准的对齐。即使问对了问题,模型和专家仍可能对“编辑是否足够完整”“某个缺陷是否应导致拒绝”持不同口径。专家标签提供决策边界,平衡数据抑制捷径学习,rescue 则为困难检查项提供监督。
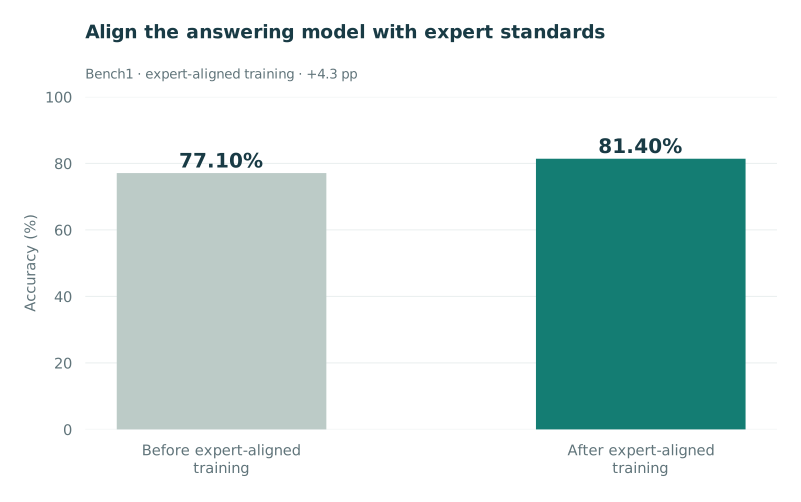
这组训练对比反映完整的专家对齐配置,包括数据设计和优化。Gold-Rescue 进一步将 V2 verifier 从 81.4% 提升至 82.7%。两类结果共同说明:PAR 同时优化了“问题怎么问”和“答案怎么判”。
这也解释了它的上限:明确的问题无法让不可见的细节自动变得可见,与专家对齐的决策规则也无法可靠使用模型感知不到的证据。此时需要增强答题过程本身。
未来的 PAR:System 1 与 System 2 混合系统
Rubric 已经存在,但答案仍然错误
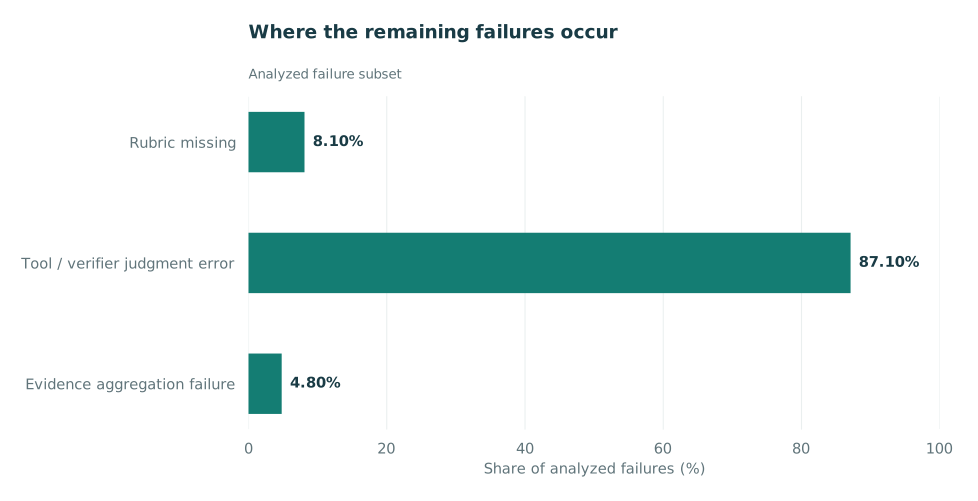
对 186 个剩余失败样本 的分析显示:15 个缺少 rubric,162 个已存在相关 rubric 但工具或 verifier 判断错误,9 个与证据聚合有关。在这个子集中,仅增加问题覆盖率无法解决主要瓶颈。
以质量崩坏为例:局部细节与瞬时缺陷
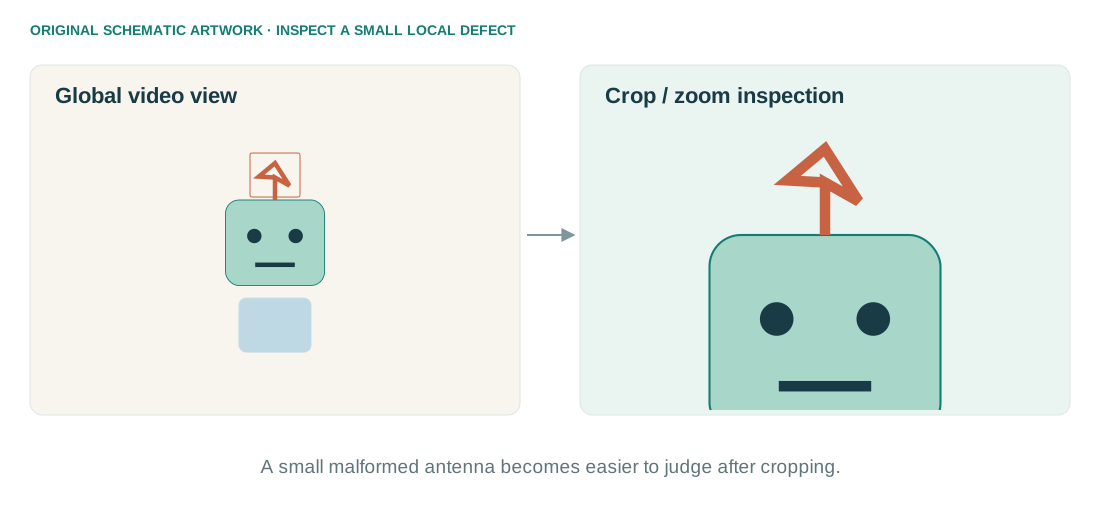
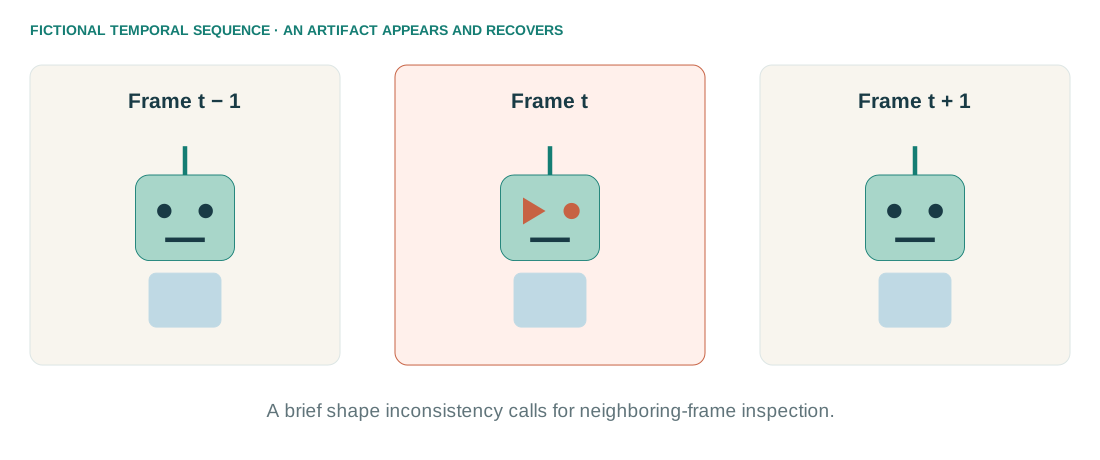
质量崩坏体现了直接二分类验证难以覆盖的一类能力,主要有两种模式。空间局部缺陷可以隐藏在整体正常的画面中:全局场景合理,但小范围的人脸、手、道具或物体部件发生变形。瞬时缺陷可能只在某帧出现,随后立刻恢复,需要比较局部区域随时间的变化才能识别。
这两类问题都需要更细致的答题过程:定位可疑区域,crop 或 zoom,必要时观察相邻帧,再判断是否存在真实崩坏。以下两个虚拟示例分别展示这两类问题。
工具辅助推理的诊断实验
随后在 Bench5 的 63 个确认存在编辑崩坏的样本上比较识别效果。直接二分类验证识别出 14.3%,质量专家为 42.9%,基础崩坏检测器为 41.3%。由此提出两个问题:模型是看到了证据却识别不出细小缺陷,还是找不到包含缺陷的关键帧?
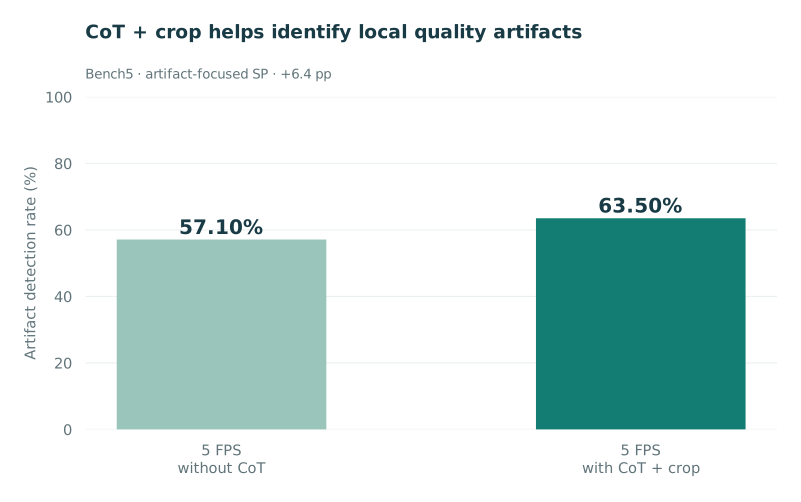
相同 5 FPS 采样率下,CoT 与 crop 检查帮助模型审视局部证据、识别更多缺陷,说明 rubric 已经指明检查内容后,增强答题过程仍然有效。
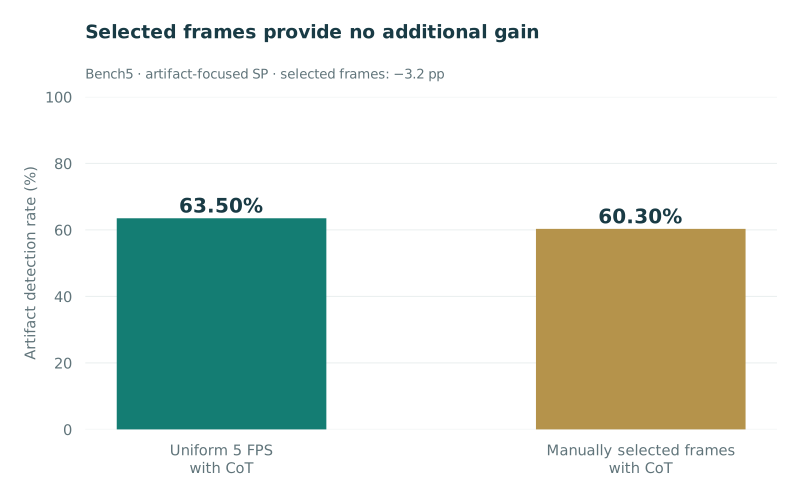
人工选帧加 CoT 比均匀 5 FPS 低 3.2 个百分点。这组诊断中,选帧没有增加收益,CoT 加 crop 却提高了识别率。结果指向局部细节识别是主要瓶颈,而非找不到关键帧:5 FPS 对本次比较已经足够。更有价值的是细看已经提供的证据。
PAR 定义检查项,答题过程按能力调整
我们提出根据答题基座已经具备的能力组织混合系统。对于基座覆盖的 rubric 类别,可以通过专家对齐训练学习可靠的判断规则,用 System 1 快速进行直接二分类验证。
对于基座仍难处理的类别,例如细小局部区域的崩坏识别,则启用 System 2:结合更复杂的思维链和 crop、zoom、相邻帧检查。Rubric 定义任务要求,答题路径负责获得足以验证的证据。时间不一致或证据冲突也可以使用这种更细致的过程。
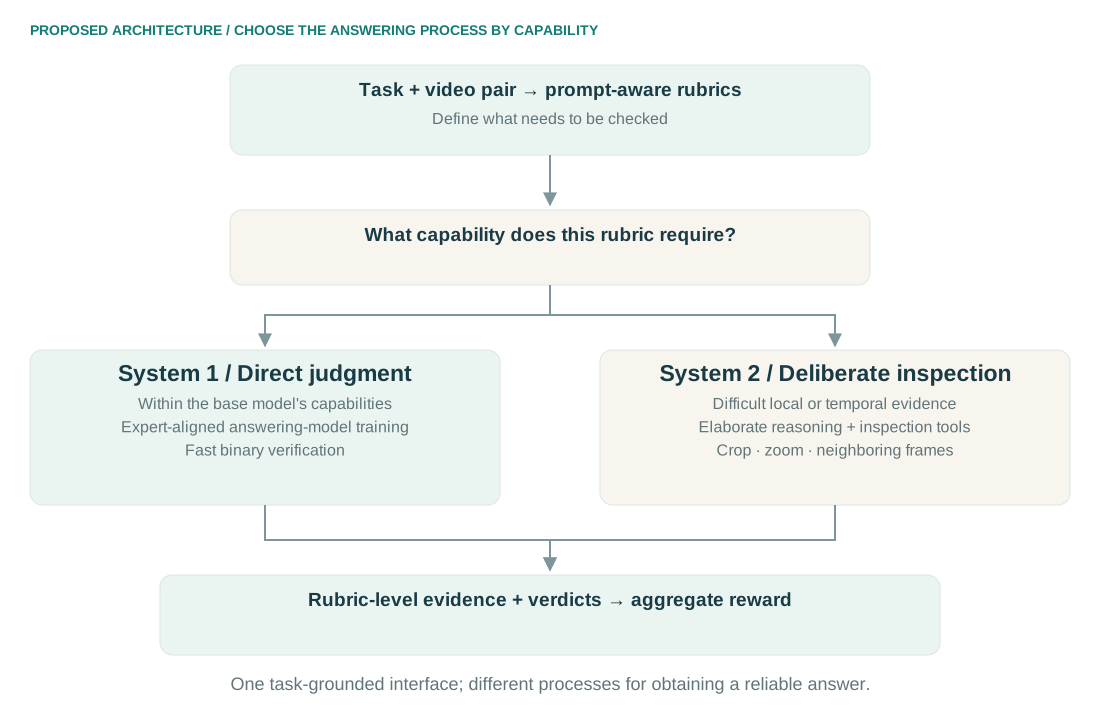
两条路径最后都可以输出相同的二分类判断,差别在于获得证据的过程,而非结果是 0 还是 1。PAR 提供统一接口:任务相关问题、回答所需证据,以及能用于评测、筛选或奖励构造的结果。
类 Jev 的 RLCD:缓解 rubric 分数的过度自信
从二分类判断到可用的奖励概率
与类 Jev verifier 类似,PAR 答题模型既可以输出二分类结论,也可以提供 rubric 被满足的概率。当这些概率被聚合用于筛选,或直接作为 RL 奖励时,概率本身就很重要。如果模型对不确定甚至错误的判断也给出接近 1.0 的分数,即使输出格式和决策规则正确,仍可能产生虚高奖励。
我们探索了受 RLCD 启发的答题模型训练校准变体,在 GRPO 设置中加入基于 Brier 的概率纠正。实验采用 Brier 思路的实现;由于实验记录中没有可用的 Jev 官方 RLCD 训练方案,因此不是对其官方配方的复现。
基于 Brier 的纠正减少对极端置信度的推动
对于二元 rubric 标签 \(y\in\{0,1\}\) 和预测满足概率 \(p\),Brier loss 为:
实验将概率纠正信号概括为 \(y-p\),它是与 Brier loss 对应的纠正方向。正类已经获得高概率时,继续向上推的幅度变小;负类被赋予高概率时,负向纠正较强。其目的在于减少过度自信,尤其是高置信的假阳性。
从总体分布看,若 \(q=P(Y=1\mid x)\),则 \(\mathbb E[y-p\mid x]=q-p\),稳定点在 \(p=q\)。这解释了校准目标,但本身不能保证完整神经网络训练过程收敛。
答题模型效果与置信度变化
在 Bench2 的独立校准实验中,GRPO-RLCD 变体提高了 precision 和 accuracy,recall 则与标准 GRPO 接近:
| 指标 | 标准 GRPO | GRPO-RLCD | 变化 |
|---|---|---|---|
| Precision | 68.91% | 71.56% | +2.65 pp |
| Recall | 75.04% | 74.40% | −0.64 pp |
| F1 | 71.84% | 72.95% | +1.11 pp |
| Accuracy | 75.33% | 76.87% | +1.54 pp |
Rubric 概率也不再那么极端:平均分从 0.803 降至 0.775,分数落在 [0.95, 1.00] 的比例从 75% 降至 67%,接近 0.999 的虚高预测有所减少。
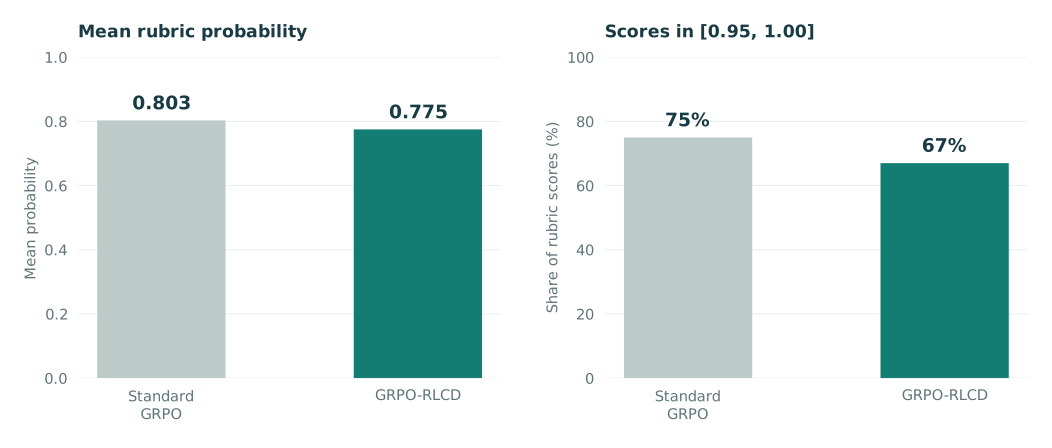
实际目标是让 rubric 概率成为更有用的奖励信号。这条训练方向与主架构互补:专家对齐优化判断规则,System 2 增强困难检查,概率纠正则针对过度自信的分数。